萨姆·奥特曼:修补所有漏洞的时代结束,A... - 明星新闻
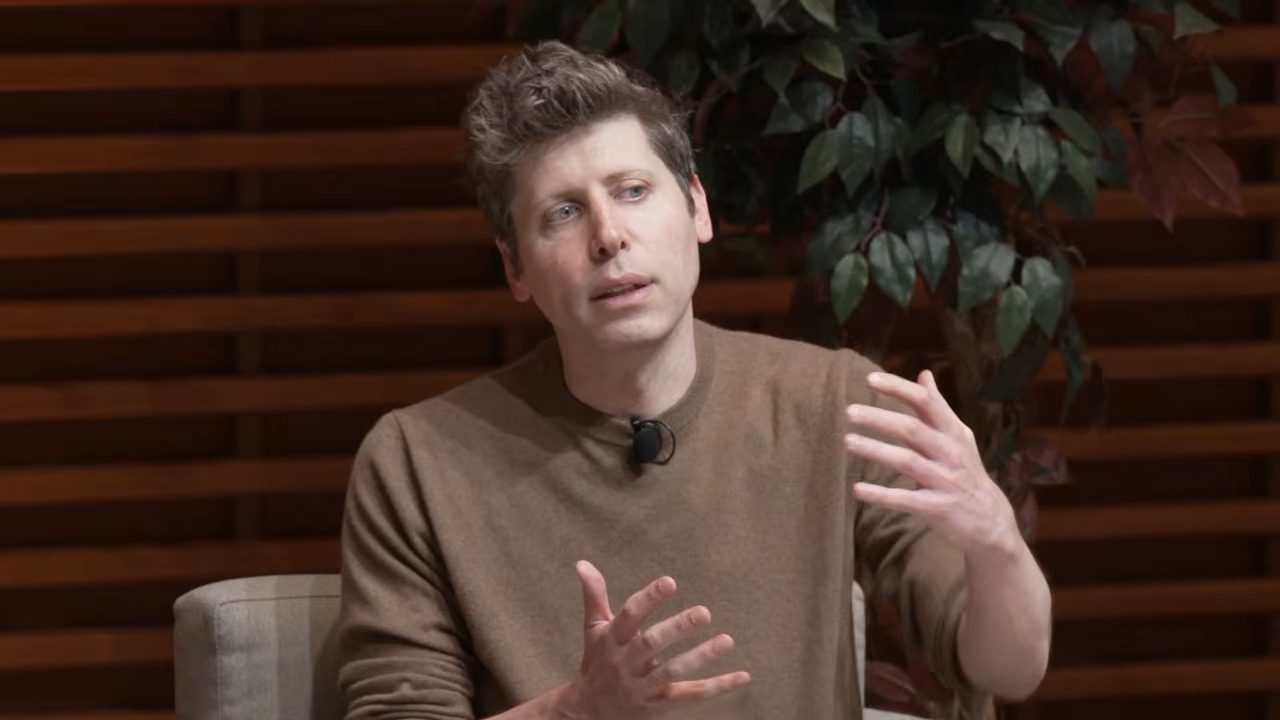
人工智能领域的领军人物、被誉为“潘多拉魔盒开启者”的萨姆·奥特曼(Sam Altman)在2026年10月26日于斯坦福大学商学院发表了一场备受瞩目的演讲。据路透社报道,奥特曼明确表示:“我不再认为我们能够修补所有漏洞。”他呼吁整个行业必须“彻底转变防御模型”。这一表态迅速引发全球科技界对人工智能安全未来走向的激烈讨论。
赛季更新奥特曼的惊人论断:传统安全模式已到尽头
在斯坦福大学商学院的圆桌对话中,OpenAI首席执行官萨姆·奥特曼直指核心问题:随着AI系统日趋复杂,传统的“发现漏洞→发布补丁”的循环模式已经失效。他通过视频连线的演讲被现场记录,随后在多个平台传播。奥特曼强调:“过去的经验告诉我们,只要投入足够资源就能封堵每一个安全缺口,但现在这个假设不再成立。”据PC Gamer报道,这位AI先驱坦承,自己已经改变了长期以来的信念,因为现代AI系统所暴露的安全面远超传统软件。“我们正面对一个完全不同的威胁图景。”奥特曼说道。
赛季奖励潘多拉魔盒效应:AI加速催生新威胁
奥特曼用“潘多拉魔盒开启者”形容自己,意指AI技术释放的巨大能量既带来机遇也带来前所未有的安全挑战。他指出,生成式AI模型(如GPT系列)的代码行数虽然不多,但其内部动态行为的复杂性使得传统静态分析与渗透测试难以全面覆盖。更糟糕的是,攻击者也在利用AI自动发现和利用漏洞,使防御方始终处于被动。美联社确认,在演讲中奥特曼引用了一项内部估算:全球AI相关系统在2025年至2026年间遭到的零日攻击数量激增了约80%。他警告说,AI本身就是一把双刃剑——它可以用来自动化漏洞修复,也可以用来自动化漏洞武器化。
段位奖励为什么“修补所有漏洞”已不再现实
这一观点的核心在于软件规模的质变。奥特曼以OpenAI的对话模型为例,指出即使训练数据经过严格清洗,模型的 emergent behaviors(涌现行为)仍可能创造出开发团队未知的攻击向量。传统安全模型假设攻击面是已知并可穷举的,但AI模型的推理路径千差万别,任何未经预见的输入组合都可能触发危险输出。根据CNBC的后续分析,奥特曼团队已经识别出超过2500种独特的攻击模式,但其中只有约15%能够通过传统补丁稳定修复。其余模式的修复往往在其他输入中引入新的漏洞,形成“修补不补”的困境。
排位技巧新防御模型的雏形:从修补转向实时对抗
面对这一困局,奥特曼提出了一个大胆的路线图:彻底抛弃“先有漏洞再补”的思路,转而建立“持续动态防御”体系。他透露OpenAI正在试验一种被称为“对抗性屏蔽(Adversarial Shielding)”的技术,该技术不是直接修改模型参数,而是在推理层实时监测输入输出,识别并拦截可疑交互。“我们不再保证模型本身无漏洞,而是保证每次交互都受到监控和阻截。”奥特曼在演讲中解释道。这种思想借鉴了零信任架构,但定制化用于AI系统。行业分析师指出,该模型需要巨大的计算资源,但可能是应对AI特有风险的最现实路径。
| 防御方式 | 传统补丁模型 | 新对抗性屏蔽模型 |
|---|
| --- | --- | --- |
|---|
| 核心思路 | 发现漏洞→开发补丁→全面更新 | 实时监控→动态阻断→持续适应 |
|---|
| 覆盖范围 | 已知漏洞(约15%可修复) | 未知及已知异常行为(预期覆盖率>60%) |
|---|
| 资源消耗 | 每次补丁需数周至数月 | 持续占用10%-20%推理算力 |
|---|
| 可扩展性 | 线性增长,与漏洞数量成正比 | 指数增长,依赖AI自身学习 |
|---|
| 代表公司 | 多数传统安全厂商 | OpenAI内部试验项目 |
|---|
行业反应与争议:乐观者与质疑者并存
奥特曼的言论立即分化了安全社区。谷歌AI安全团队负责人杰弗里·摩尔(Jeffrey Moore)表示:“奥特曼指出了真实痛点,但完全放弃补丁模型可能过于激进。我们仍需要分级策略。”而知名白帽黑客、漏洞赏金平台HackerOne的合作伙伴艾米莉·陈(Emily Chan)则对路透社表示:“奥特曼说出了许多安全研究员不敢公开讲的实话。我们每天面对数千个AI相关威胁,大多数都无补丁可用。”但也有专家质疑新模型的实际效能。独立研究员汤姆·里德(Tom Reed)在社交平台指出:“对抗性屏蔽听起来很好,但一旦攻击者学会欺骗监控器,它就变成了虚假安全感。”《华尔街日报》引用的一份调查显示,在受访的200家使用AI产品的大企业中,62%表示对AI安全前景感到担忧,但仅有23%计划额外增加AI安全预算,反映出意见与行动的差距。
FAQ 段
Q1: 奥特曼是否认为AI安全已经无法改善?
A1: 不。他并非主张放弃安全,而是认为沿用传统安全框架(逐漏洞修补)已无法应对AI威胁。他提倡转向实时动态防御模型,利用AI自身能力对抗攻击,这实际上代表了更积极的改善方向。
Q2: 新防御模型会对普通用户产生什么影响?
A2: 短期影响较小。长期来看,若新模型推广,用户可能会观察到AI交互出现间歇性延迟(因实时监控),同时恶意内容将更少出现。但对使用API的开发者而言,可能需要调整应用接口以适配对抗屏蔽层的审查规则。
萨姆·奥特曼此次演讲标志着AI安全思维的一次重大转折——从“可补尽补”转向“全面防御”。尽管新路线仍充满不确定性与争议,但它为处于安全困境中的行业提供了一个全新的思考起点。未来数年,如何平衡AI的开放性与安全性,将决定人工智能这项革命性技术能否获得持久信任。
欧美明星
OpenAI CEO 萨姆·奥特曼在斯坦福演讲中称传统漏洞修补模式已失效,需转向实时对抗防御。文章详解新安全模型、数据对比及行业争议,探讨AI安全漏洞的未来出路。